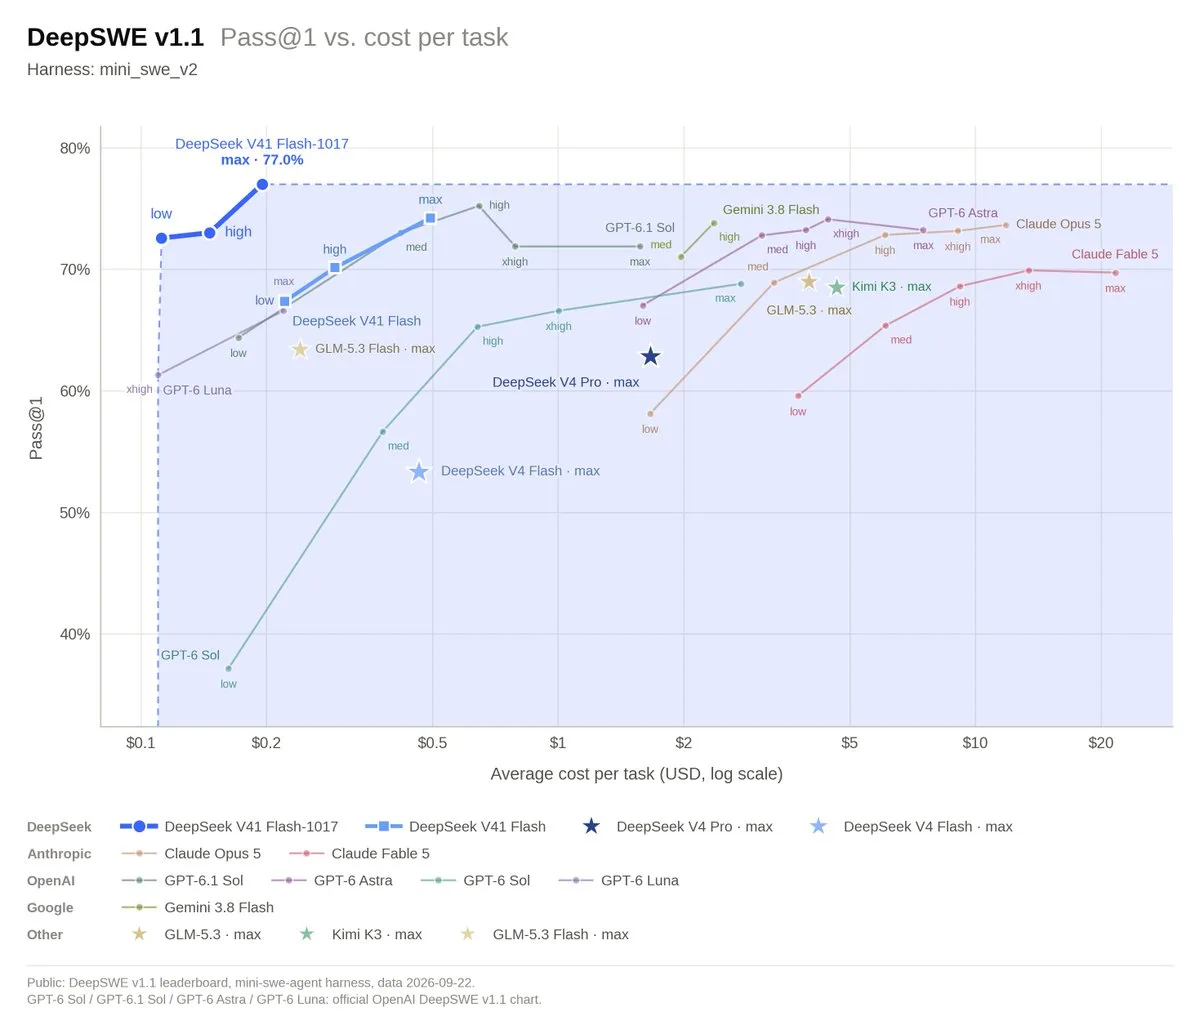
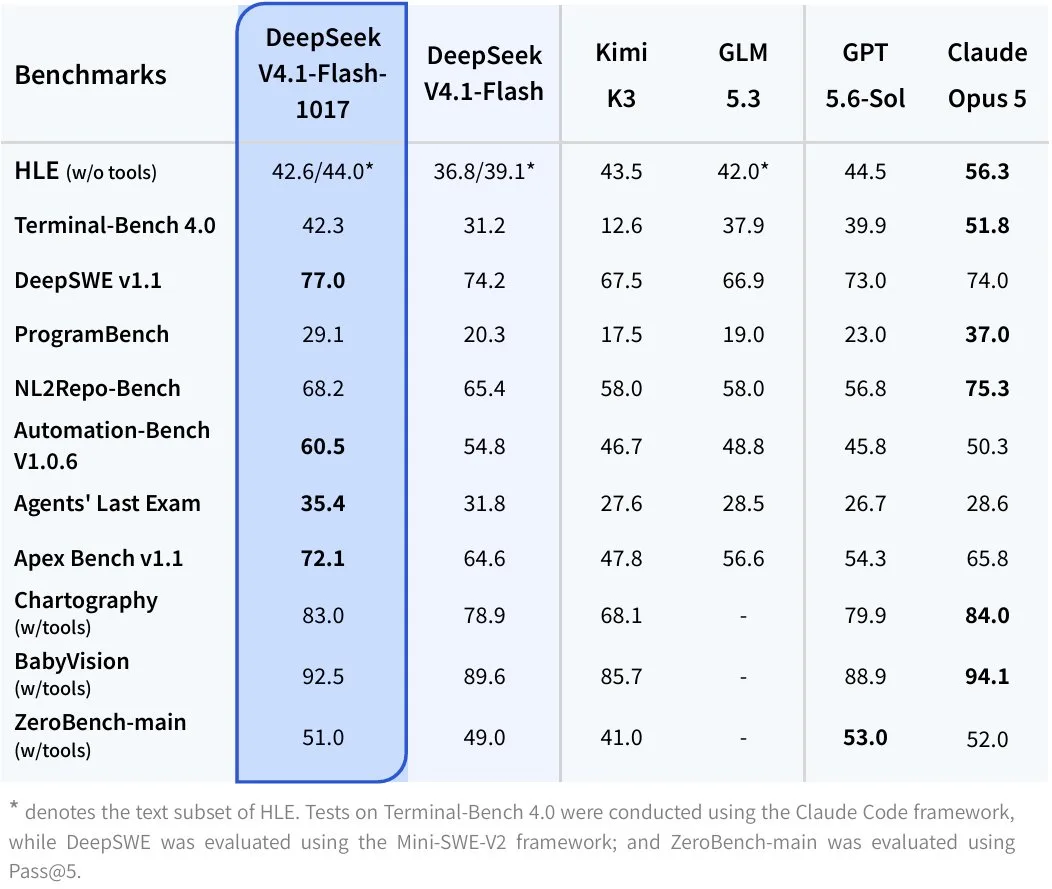
DeepSeek odświeżył swój model do programowania. Wersja V4.1-Flash-1017 ma łączyć wysoką skuteczność z niskimi kosztami działania. Według przytoczonych wyników zdobywa 77% w DeepSWE 1.1, wobec 74% modelu Opus 5.0. W AutomationBench przewaga wynosi 60,5% do 50,3%, a w Apex Bench — 72,1% do 65,8%. Wu Yu, szef zespołu odpowiedzialnego za dotrenowywanie modeli DeepSeek, zapowiada wręcz erę powszechnie dostępnego programowania przez opisywanie oczekiwanego efektu.
Najważniejsze zmiany dotyczą pracy w środowiskach, w których AI samodzielnie pisze kod, testuje go i poprawia błędy w kolejnych podejściach. Nowego Flasha dostrojono właśnie do takiej pętli, także z użyciem narzędzi DeepSeek. Model ma też mniej się rozpisywać i szybciej przechodzić do kodu lub konkretnej odpowiedzi. Pomogło w tym uczenie ze wzmocnieniem: premiowano krótką, skuteczną drogę do rozwiązania, a ograniczano zbędne wywody. Mniej tokenów ma oznaczać szybsze odpowiedzi i niższe koszty.
Podstawowa architektura pozostała bez zmian. Zachowano m.in. Causal Encoder-Decoder, mechanizm uwagi CSA2, kwantyzację FP4 i SWA Bounded Replay. Według opisu pozwala to ograniczyć pamięć podręczną KV do zaledwie 890 bajtów na token. DeepSeek stawia więc na usprawnienie istniejącej konstrukcji i sposobu jej trenowania. Wyniki benchmarków wyglądają obiecująco, choć same nie rozstrzygają, jak model poradzi sobie w codziennej pracy nad kodem.
Dodam od siebie, że ostatnie modele, które sam testowałem i naprawdę dobrze wspominam, to te z rodziny Llama i ich pochodne — głównie małe warianty 7B i niżej. Za numer generacji już nie dam sobie ręki uciąć. Chyba pora nadrobić zaległości i sprawdzić, czy ten DeepSeek faktycznie tak dobrze radzi sobie poza tabelkami 😉
Komentarze (0)
Brak komentarzy. Bądź pierwszy!
Dodaj komentarz
Dołącz do dyskusji
Po zalogowaniu komentujesz, a jeśli zechcesz, przy Twoim nicku widać Twój zestaw - inni od razu wiedzą, z jakiego sprzętu piszesz.